 Dolphin AI
多模型调用管理需要同时回答四个问题:应用可以使用哪些模型、请求如何选择渠道、超限时如何处理,以及消耗如何归属。AI 网关可以集中配置这些治理环节,但费用分析仍需结合供应商价格、统计口径与账单核对,不能仅凭请求量推断成本。
先整理模型与调用方清单
为每个渠道记录模型标识、服务地址、协议、上游额度、价格依据和维护人。再区分业务应用或团队的访问身份,明确哪些令牌可以使用哪些模型。共享同一个令牌会削弱成本归属的精度。
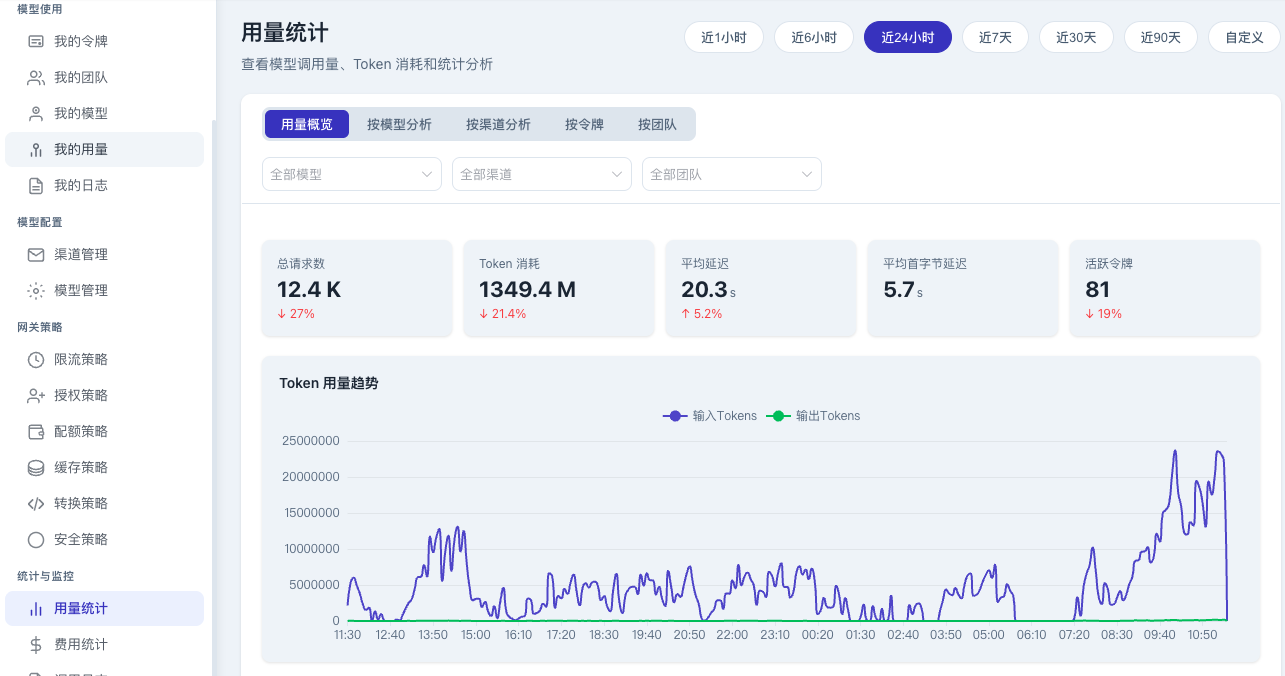
得帆平台可按模型、渠道和令牌分析使用情况。若要汇总到部门,实施时应维护令牌与组织的对应关系,并验证统计口径,而不是默认任意组织维度都已自动覆盖。
把路由与三类负载约束一起设计
路由决定调用路径,限流约束调用负载,授权决定谁能调用。这三类规则应分别设计,再组合验证。得帆网关提供五种路由模式,可按实际场景配置渠道绑定与模型映射。
单一渠道可从直达模式开始;需要分配调用比例时评估权重分流;有主次渠道或条件分流需求时,分别评估优先级与规则路由。智能路由的判断依据和效果应结合实际配置与测试确认。
- 并发:限制同时进行的请求,关注长耗时调用占用。
- RPM / RPD:约束每分钟或每天的请求次数。
- TPM / TPD:约束每分钟或每天的 Token 用量。
优先级队列适合需要等待共享并发额度的场景,但应验证等待与拒绝行为;应用端还需明确超时和重试策略。
统一费用计算与对账口径
一个用于理解成本的简化关系是:输入 Token × 输入单价 + 输出 Token × 输出单价。实际费用还可能涉及不同计价单位、缓存、多模态或供应商专项规则,必须按具体账单口径核对;这不是本网站提供的报价公式。
| 项目 | 需要统一的口径 |
|---|---|
| 统计周期 | 起止时间、时区及数据延迟 |
| 价格配置 | 模型版本、币种、计价单位与价格生效时间 |
| 调用行为 | 重试、失败请求与缓存的计量方式 |
| 归属关系 | 模型、渠道、令牌与业务负责人 |
用量分析之后,还要验证调整结果
- 观察一段有代表性的业务周期,记录请求、Token、费用、成功率与延迟。
- 识别异常增长对应的模型、渠道或令牌,再结合调用日志判断原因。
- 按原因调整路由或限流配置,避免仅为了减少消耗而影响关键业务。
- 在可比较的条件下复核调整后的使用情况与业务结果。
得帆提供用量、费用、日志和告警相关能力。能否降低成本以及降低多少,应由实际业务数据验证,不应预设固定比例。
实施问答
并发、请求频次与 Token 限流如何搭配?+
并发限制控制同时处理的请求,RPM / RPD 控制每分钟或每天请求数,TPM / TPD 控制每分钟或每天 Token 用量。应结合上游额度和业务负载配置,并通过测试确认各规则的生效范围。
超限后拒绝还是排队?+
并发控制支持拒绝模式与优先级队列模式。拒绝模式达到上限返回 429;队列模式按令牌优先级等待共享租户额度。应用端需要处理拒绝或等待结果,等待时间与重试策略应在联调中验证。
用量统计是否可以直接当作供应商账单?+
平台支持按模型、渠道和令牌分析请求、Token 与费用。对账时仍需核对价格配置、计量口径、统计周期及供应商账单。页面中的演示数值不代表实际价格、性能或节省比例。
产品能力依据得帆对应产品介绍资料整理;页面中的实施步骤、试点与验收项为建议。具体接入、配置和运行效果以实际部署版本及联调结果为准。
查看得帆 AI 网关的产品界面与功能 ↗